11 · Spring AI:Java 团队几乎唯一的成熟选择
前置:写过 Spring Boot。不需要懂 Python 生态。
Agent 生态是 Python 的天下,这是事实。但你们的订单系统、风控、权限、监控全在 Spring Boot 里,已经跑了五年。
现在要加一个会调工具的助手。你有两个选择:另起一个 Python 服务,然后处理跨语言调用、两套部署、两套监控、两边的事务怎么对齐;或者就在现有工程里加几个类。这一篇讲第二条路现在成熟到什么程度。
| 仓库 | spring-projects/spring-ai 9.3k + alibaba/spring-ai-alibaba 10.6k |
| 版本 | Spring AI 2.0.0(Boot 4.x)/ 1.1.x(Boot 3.5.x);SAA 1.1.2.2 |
| 语言 | Java(JDK 17+) |
| 许可证 | Apache 2.0 |
| 层级 | Framework(SAA Graph 补上 Runtime 层) |
| 一句话 | 把 Spring 的可移植性和模块化原则套到 AI 上:ChatClient 之于 LLM,就像 RestClient 之于 HTTP |

图片来源:Spring AI 官方文档
一、Java 这边一共有几个选项
留在 Spring 里的好处很实在:事务、连接池、监控、鉴权、CI/CD 全是现成的,不用为一个助手再搭一套。
本专题里 Java 可选项一共就两个半:
| 选项 | Star | 评价 |
|---|---|---|
| Spring AI | 9.3k | 官方出品,抽象最正统,生态最深 |
| Spring AI Alibaba | 10.6k | 建在 Spring AI 上,补齐 Graph、多智能体、Admin 平台 |
| ADK Java | 1.7k | Google 出品但生态很薄 |
先说结论:Java 团队做 Agent,走 Spring AI(+ Spring AI Alibaba)这条路,几乎没有第二个理性选择。
二、核心抽象:ChatClient 流式 API
Spring AI 的设计哲学一眼就能看出来 —— 它长得像 RestClient / WebClient:
@RestController
class MyController {
    private final ChatClient chatClient;

    // Spring Boot 自动配置好 ChatClient.Builder 注入进来,
    // 用哪家模型由 application.yml 和你引的 starter 决定,代码里看不到
    public MyController(ChatClient.Builder chatClientBuilder) {
        this.chatClient = chatClientBuilder.build();
    }

    @GetMapping("/ai")
    String generation(String userInput) {
        return this.chatClient.prompt()   // 开始构造一次请求
            .user(userInput)              // 用户消息
            .call()                       // 同步执行(异步流式用 .stream())
            .content();                   // 取纯文本结果
    }
}
对 Spring 开发者来说,这段代码不需要学习 —— 构造器注入 Builder、流式链式调用、call() 终结操作,全是肌肉记忆。这是 Spring AI 最大的价值:零心智成本地把 LLM 变成 Spring 生态里的又一个客户端。
2.1 结构化输出:直接映射成 record
// 用 Java record 声明你想要的结构,一行搞定
record ActorFilms(String actor, List<String> movies) {}

ActorFilms actorFilms = chatClient.prompt()
    .user("Generate the filmography for a random actor.")
    .call()
    .entity(ActorFilms.class);      // entity() 负责:生成 schema → 约束模型 → 解析成对象

// 泛型集合也支持,用 ParameterizedTypeReference 把泛型信息带进去
// (Java 泛型运行时会擦除,所以需要这个匿名子类的写法)
List<ActorFilms> films = chatClient.prompt()
    .user("Generate the filmography of 5 movies for Tom Hanks and Bill Murray.")
    .call()
    .entity(new ParameterizedTypeReference<List<ActorFilms>>() {});

// spec 可以细调:validateSchema() = 校验模型输出,不合格自动重试;
// useProviderStructuredOutput() = 用供应商原生的结构化输出能力而非提示词约束
ActorFilms validated = chatClient.prompt()
    .user("...")
    .call()
    .entity(ActorFilms.class, spec -> spec.validateSchema());
.entity(Class) 这个 API 在强类型语言里比 Python 的 Pydantic 方案更自然 —— 编译期就知道类型,IDE 全程补全。
2.2 流式
// stream() 代替 call(),返回 Reactor 的 Flux,可以直接接进 WebFlux 往前端推
Flux<String> output = chatClient.prompt()
    .user("Tell me a joke")
    .stream()
    .content();     // 每个元素是一小段文本;要拿完整响应对象就用 .chatResponse()
返回 Reactor 的 Flux,直接接进 WebFlux。
三、Advisors:Spring AI 版的中间件
Advisor 是 Spring AI 的横切扩展点,概念上等价于 LangChain 的 Middleware,实现上则是 Spring 开发者熟悉的拦截器模式。
chatClient.prompt()
    .advisors(a -> a
        .advisors(
            // 请求发出前自动把这个会话的历史消息拼进去
            MessageChatMemoryAdvisor.builder(chatMemory).build(),
            // 请求发出前自动去向量库检索相关片段,拼成上下文 —— 这就是 RAG
            QuestionAnswerAdvisor.builder(vectorStore).build()
        )
        // ⚠️ 用了 MessageChatMemoryAdvisor 就必须传会话 ID,否则不知道该取谁的历史
        .param(ChatMemory.CONVERSATION_ID, conversationId))
    .user(userText)
    .call()
    .content();
内置 Advisor:
| Advisor | 作用 |
|---|---|
MessageChatMemoryAdvisor | 自动带上会话历史(必须传 ChatMemory.CONVERSATION_ID) |
QuestionAnswerAdvisor | RAG:从向量库取相关上下文拼进提示词 |
SimpleLoggerAdvisor | 请求 / 响应日志 |
ToolCallingAdvisor | 工具执行,默认自动注册 |
「RAG 是一个 Advisor」这个设计很值得玩味 —— 在 Spring AI 里,检索增强不是一套独立的 pipeline,而是挂在调用链上的一个拦截器。一行 QuestionAnswerAdvisor.builder(vectorStore).build() 就把 RAG 接上了。
3.1 工具调用
String response = ChatClient.builder(chatModel)
    .build()
    .prompt("What day is tomorrow?")
    // 传一个普通对象进去,里面用 @Tool 注解的方法会被扫描成工具,
    // 参数 schema 从方法签名自动推断。ToolCallingAdvisor 会自动注册,
    // 也就是「执行工具 → 把结果回传模型」这一步不用你写
    .tools(new DateTimeTools())
    .call()
    .content();
工具类里用 @Tool 注解方法,参数 schema 从方法签名推断。
3.2 全局默认值配置
@Bean       // 定义成一个 Spring Bean,全应用注入同一份配置
ChatClient chatClient(ChatClient.Builder builder) {
    return builder
        .defaultSystem("You are a helpful assistant")                      // 默认系统提示词
        .defaultOptions(ChatOptions.builder().temperature(0.7).build())    // 默认采样参数
        .defaultTools(new DateTimeTools())                                 // 默认工具集
        .defaultAdvisors(                                                  // 默认拦截器链
            MessageChatMemoryAdvisor.builder(chatMemory).build(),
            QuestionAnswerAdvisor.builder(vectorStore).build())
        .build();
}
// 「default」开头的都是默认值,单次调用时仍可覆盖 —— 团队规范和灵活性两头都占
一个 @Bean 定义团队的默认 Agent 配置,全应用共享 —— 这是 Spring 的老套路用在新地方,也是 Python 框架不太有的治理能力。
四、生态:这是 Spring AI 真正的强项
| 维度 | 覆盖 |
|---|---|
| 模型供应商 | Anthropic、OpenAI、Amazon Bedrock、Google、Ollama、Mistral、DeepSeek 等 |
| 模型类型 | Chat、Embedding、文生图、语音转写、语音合成、内容审核 |
| 向量库 | PGVector、Redis、Elasticsearch、Milvus、Qdrant、Pinecone、Weaviate、MongoDB Atlas、Neo4j、Cassandra、Oracle、Azure、Chroma 等 20+ |
| 对话记忆后端 | JDBC、Cassandra、MongoDB、Neo4j、Redis |
| MCP | Boot Starter + Java 注解,支持 STDIO / SSE / Streamable-HTTP,既能消费也能暴露 |
| 可观测性 | Micrometer 原生,直接进现有监控 |
| ETL | 文档摄取管道 |
| 评测 | 内置 evaluator,防幻觉检查 |
「向量库的可移植 API + 类 SQL 元数据过滤」是个被低估的设计 —— 换向量库不用改业务代码,这在企业里比什么都实在。
还有 start.spring.io 直接勾选 Model / Vector Store 生成脚手架,这个体验 Python 生态里没有对应物。
| Spring AI | Spring Boot |
|---|---|
| 2.x | Boot 4.x |
| 1.1.x | Boot 3.5.x |
如果你的系统还在 Boot 3.x,就用 Spring AI 1.1.x 分支,不要直接上 2.0。这个约束比框架本身的功能差异更可能决定你的选择。
五、Spring AI 的短板,和 Spring AI Alibaba 的补位
Spring AI 本身没有强编排能力 —— 没有图、没有状态机、没有 checkpoint、没有结构化 HITL。它解决的是「怎么把 LLM 接进 Spring 应用」,不是「怎么编排一个长时自主 Agent」。
这块空缺由 Spring AI Alibaba(10.6k star,比上游还多)补上:
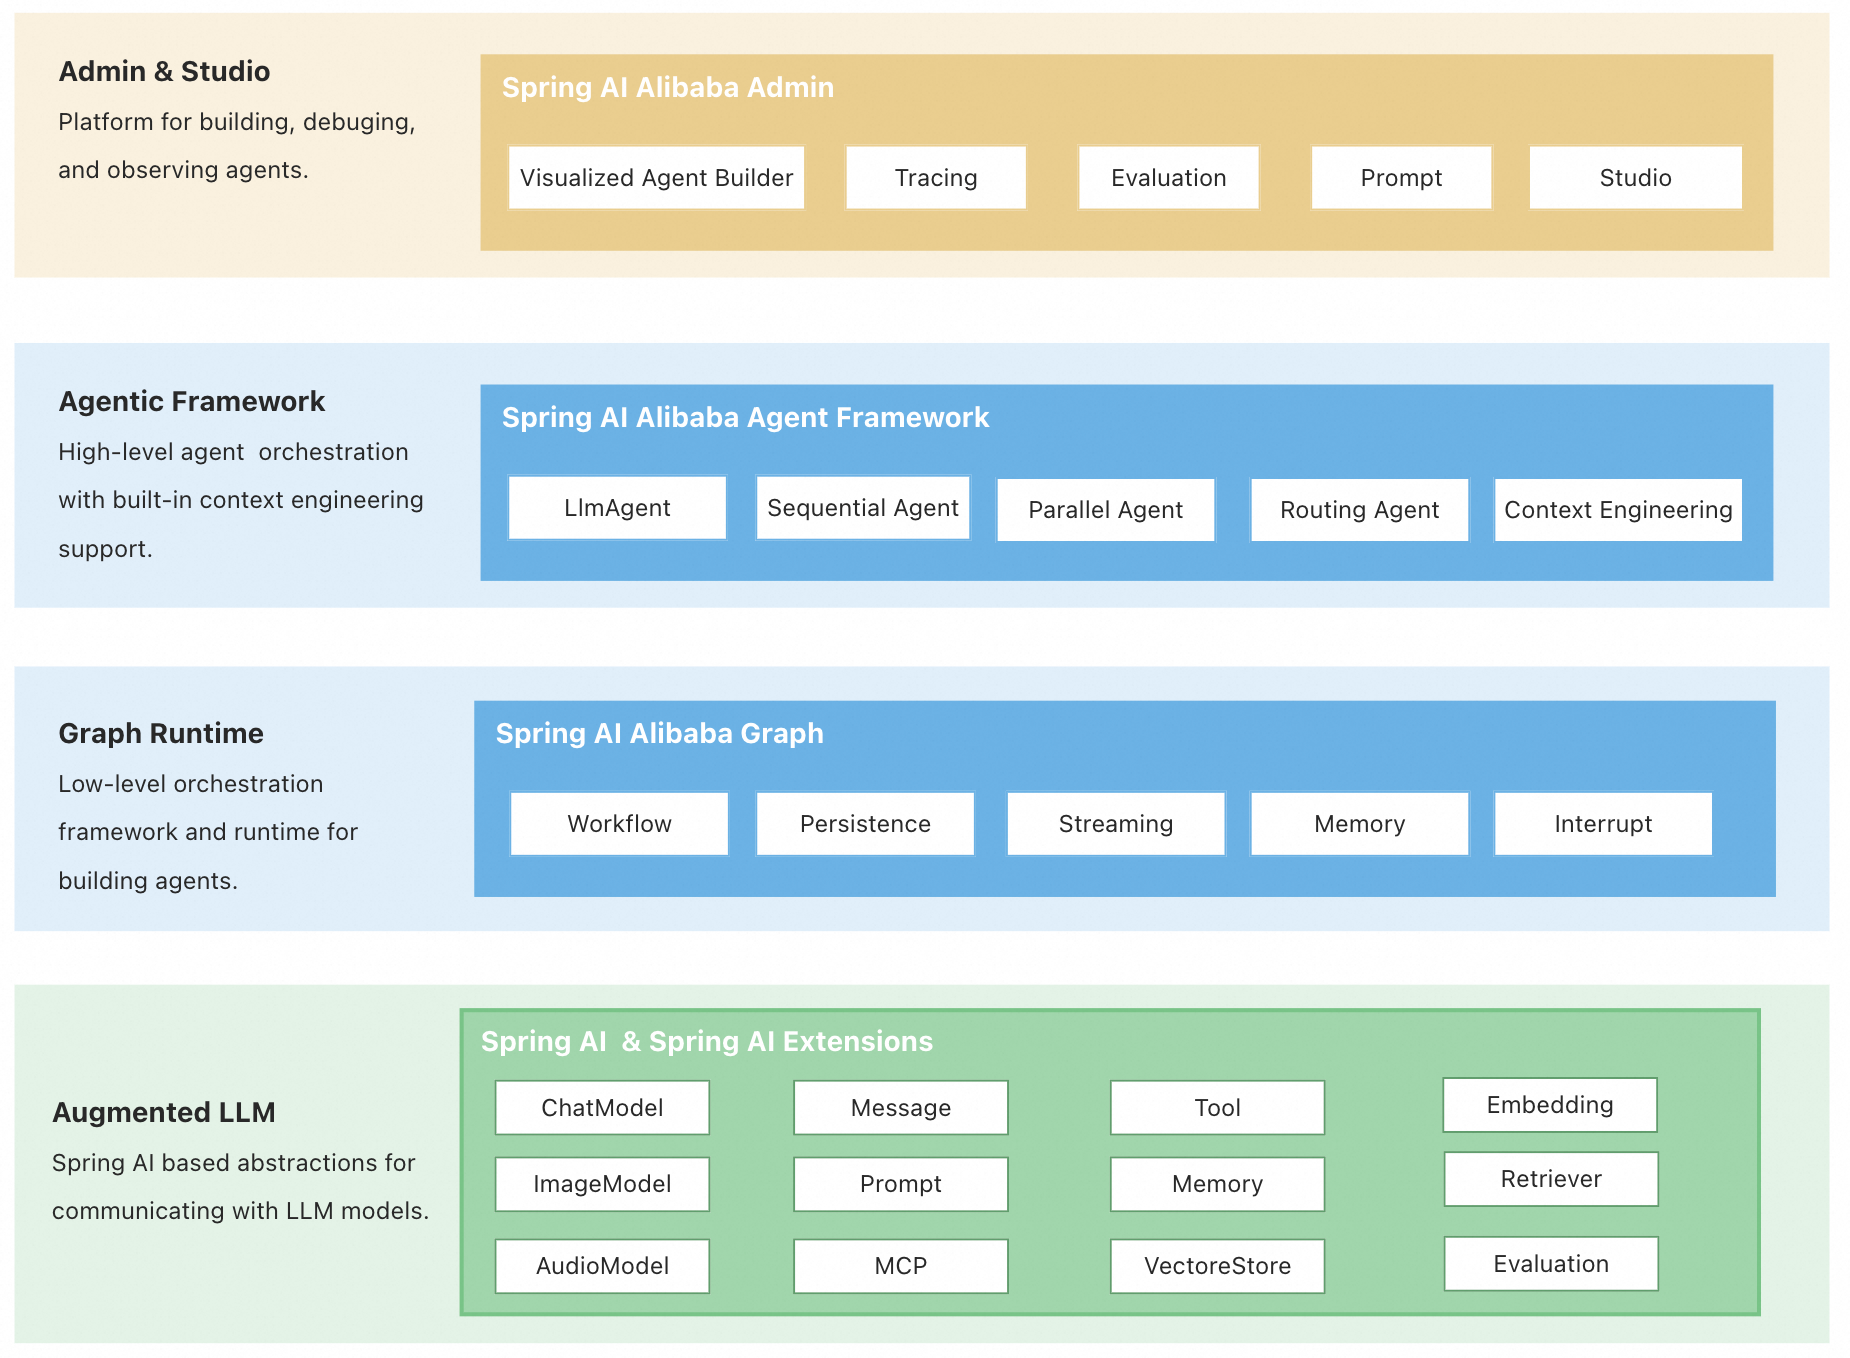
三层结构,和 LangChain 全家桶的分层 高度对应:
| SAA 层 | 干什么 | 对标 |
|---|---|---|
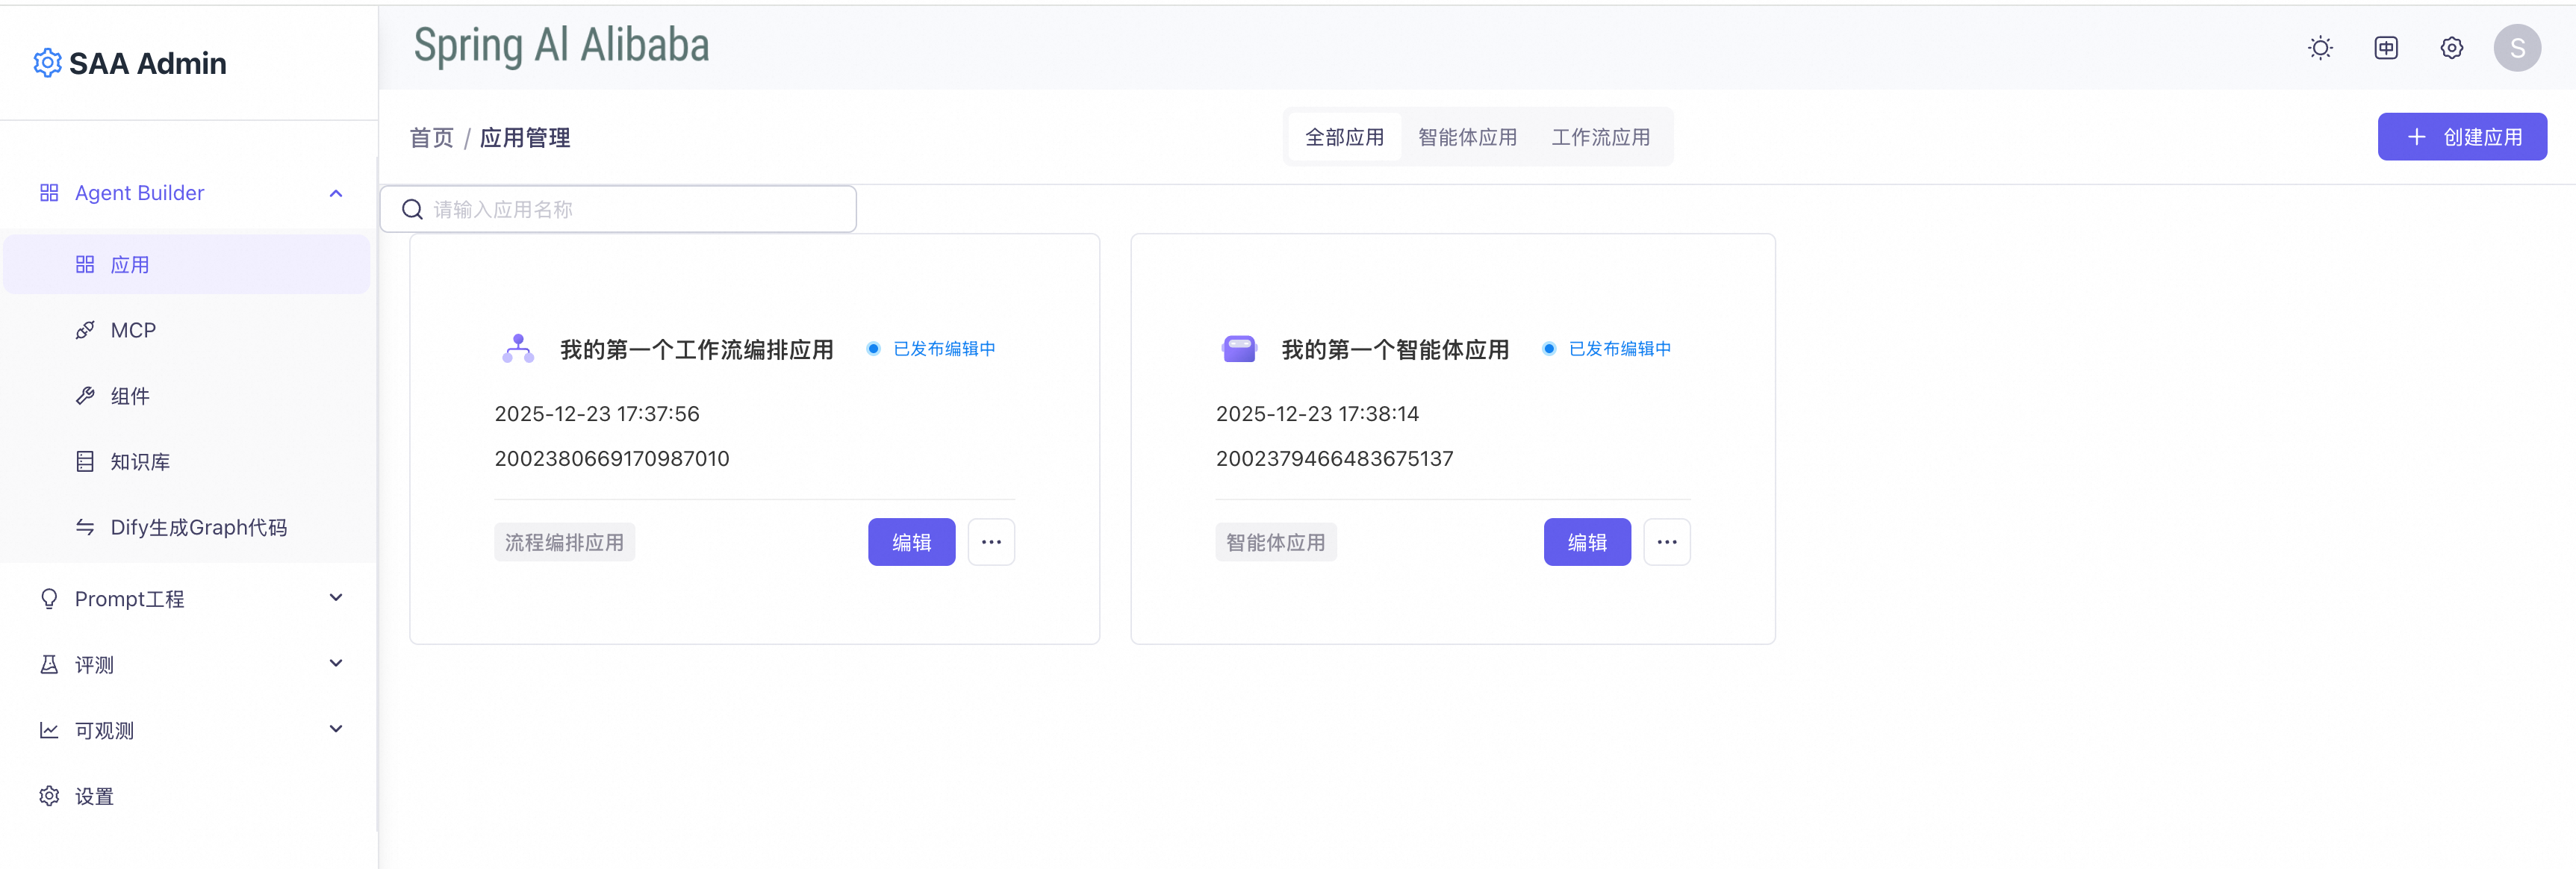
| Admin | 可视化开发、可观测、评测、MCP 管理;支持从 Dify DSL 迁移 | LangSmith + Dify |
| Agent Framework | 内置 Context Engineering 和 HITL 的 Agent,附 SequentialAgent / ParallelAgent / RoutingAgent / LoopAgent | LangChain create_agent / ADK Workflow |
| Graph | 底层运行时:持久化、工作流编排、流式,支撑长时有状态 Agent | LangGraph |
它的 Context Engineering 能力清单,几乎是 DeepAgents 那套的 Java 版:human-in-the-loop、context compaction、context editing、model & tool call limit、tool retry、planning、dynamic tool selection。
另外还有 A2A(配合 Nacos 做服务发现)、Voice Agent(WebSocket 实时语音)、工作流导出 PlantUML / Mermaid。
Java 团队的实际选法
- 只需要「在 Spring 应用里调模型 + RAG + 工具」 → 纯 Spring AI 就够,依赖最少
- 需要多智能体 / 长时任务 / 持久化 / 可视化编排 → 加 Spring AI Alibaba
- 两者不冲突:SAA 建在 Spring AI 之上,用的是同一套
ChatClient/ChatModel概念
六、和 Python 生态的差距,以及不差的地方
6.1 确实落后的
| 方面 | 差距 |
|---|---|
| 新特性时间差 | 新模型能力、新范式(Harness、Skills)通常先在 Python 出现,Java 滞后数周到数月 |
| 社区内容 | 教程、博客、Stack Overflow 答案密度差一个数量级 |
| 实验性生态 | 各种新奇的 Agent 工具库基本只有 Python 版 |
| Harness 层缺位 | 没有 DeepAgents / Claude Agent SDK 那种开箱即用的深度 Agent(SAA 的 Context Engineering 部分补位) |
6.2 反而更好的
| 方面 | 优势 |
|---|---|
| 类型安全 | entity(ActorFilms.class) 编译期检查,重构安全 |
| 可观测性 | Micrometer 原生,无需额外 SaaS,直接进现有 Grafana |
| 依赖治理 | Maven / Gradle 的依赖管理比 Python 的传递依赖地狱清爽得多 |
| 和现有系统的集成 | 事务、连接池、鉴权、配置中心全部复用 |
| 部署运维 | 一个 jar,现有 CI/CD 直接用 |
七、什么时候用 / 什么时候别用
7.1 用它,如果
- 后端主体是 Java / Spring Boot —— 这一条基本就决定了
- 要把 AI 能力嵌进现有系统,而不是新起一个独立服务
- 企业级要求高 —— 可观测性、依赖治理、审计、长期维护
- 团队没有 Python 工程能力储备 —— 让 Java 团队去维护 Python 服务是个长期成本
7.2 别用它,如果
- 要追最新的 Agent 范式 —— Python 生态永远快一步
- 团队本来就是 Python —— 没有理由为了 Java 而 Java
- 需要最丰富的第三方集成 —— LangChain 的集成数量不是 Spring AI 能比的
- 系统还在 Spring Boot 3.x 且不打算升级 —— 只能用 1.1.x 分支,会慢半拍
- Spring AI:https://github.com/spring-projects/spring-ai
- 参考文档:https://docs.spring.io/spring-ai/reference/
- ChatClient API:https://docs.spring.io/spring-ai/reference/api/chatclient.html
- Advisors API:https://docs.spring.io/spring-ai/reference/api/advisors.html
- 示例项目:https://github.com/spring-projects/spring-ai-examples
- Spring AI Alibaba:https://github.com/alibaba/spring-ai-alibaba · https://java2ai.com
- Awesome Spring AI:https://github.com/spring-ai-community/awesome-spring-ai